Par Matthieu Cordier — 8 avril 2024
La Modern Data Stack désigne un ensemble d’outils pour collecter, stocker, transformer et analyser les données.
On pourrait y voir un énième terme à la mode — et c’est peut-être le cas —, mais il traduit une transformation profonde de notre manière d’aborder les infrastructures de données et les outils d’analyse. La Modern Data Stack marque le passage des méthodes traditionnelles à une utilisation des données en libre-service et à des processus de transformation simplifiés.
Définir la Modern Data Stack
La Modern Data Stack incarne avant tout l’évolution des outils et des pratiques de l’ingénierie des données. Elle repose sur deux principes fondamentaux :
- L’utilisation des données en libre-service : donner davantage d’autonomie aux utilisateurs des données, comme les analystes et les data scientists, en leur permettant d’y accéder et de les manipuler sans dépendre fortement des data engineers.
- La simplicité des transformations : faciliter l’écriture de transformations adaptées aux besoins métier, afin que les analystes puissent structurer et visualiser les données selon leurs besoins, sans intervention importante des équipes d’ingénierie. Il peut s’agir, par exemple, de transformer les données pour les rendre exploitables dans un outil de Business Intelligence (BI), comme Tableau ou Metabase.
Est-ce que cela simplifie la vie de tout le monde ? Oui, assurément.
Est-ce parfait ? Pas encore.
Pourquoi ? Parce que cette approche ne couvre pas tous les cas de figure : il reste malheureusement nécessaire de recourir à des scripts spécifiques. Le problème n’est donc pas entièrement résolu, comme nous le verrons au fil de cet article.
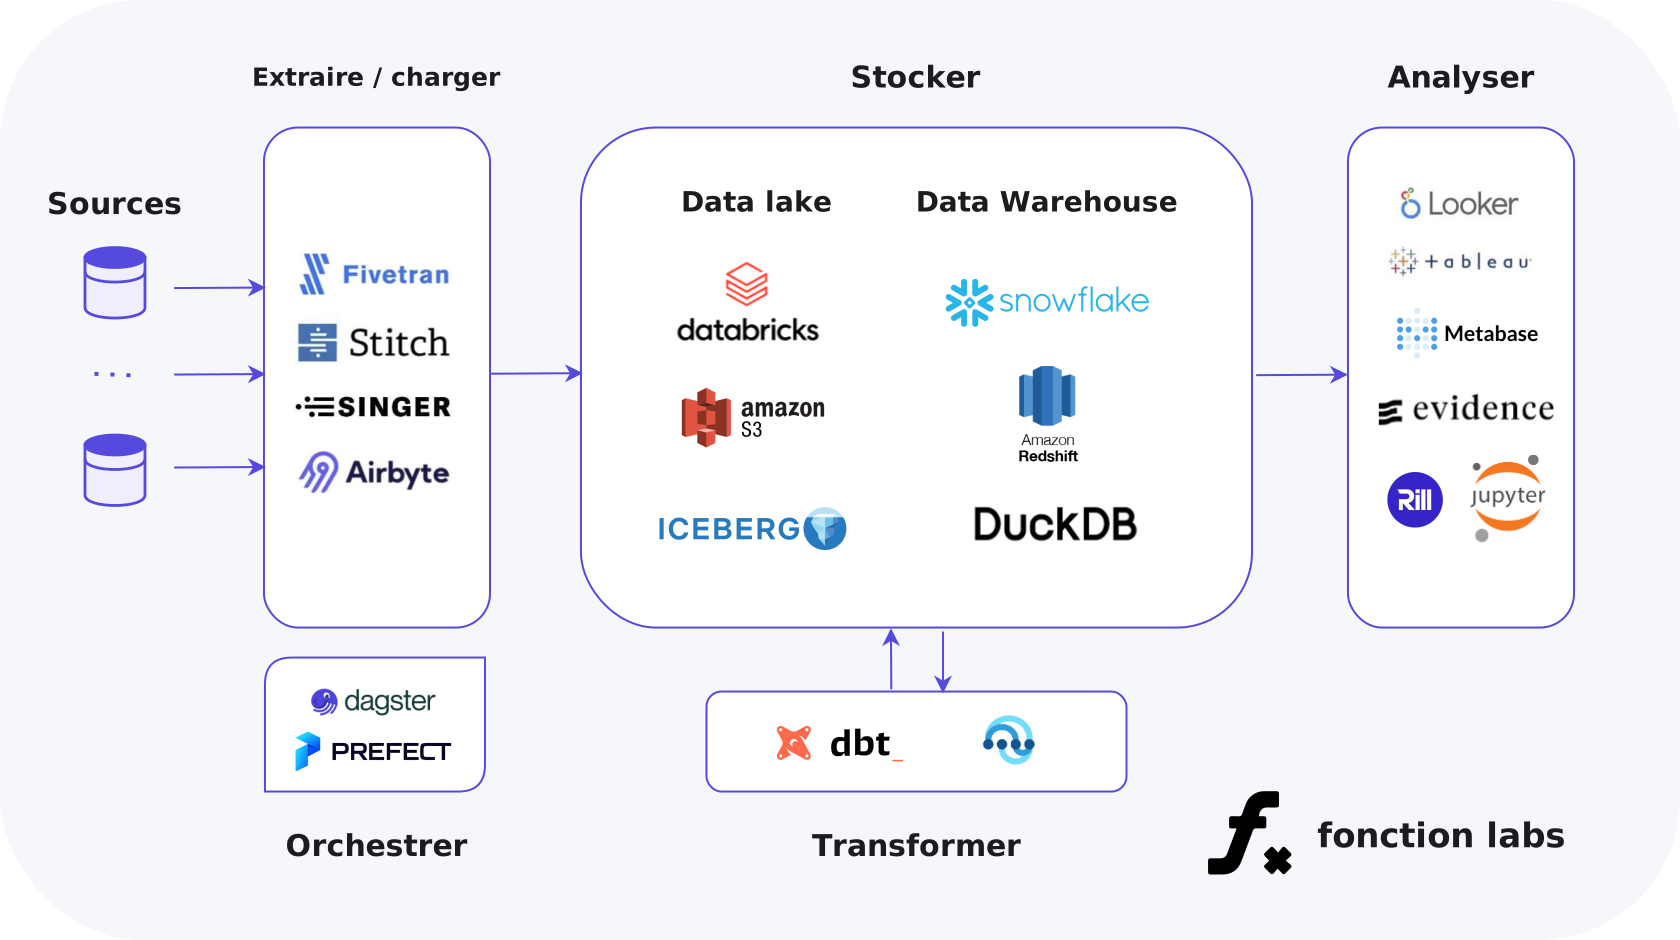
Illustration : un aperçu de la Modern Data Stack.
Retour en arrière : l’évolution de l’ingénierie des données
Remontons dans le temps. Où tout a-t-il commencé ?
Sans revenir sur les premières étapes de la BI et de l’ingénierie des données, des années 1970 aux années 2010, il y a seulement une dizaine d’années, les data engineers s’appuyaient encore largement sur des outils d’orchestration comme Airflow. Ces outils exécutaient des scripts Python ou Spark spécifiques pour gérer l’extraction, la transformation et le chargement des données.
Mais à mesure que le nombre de transformations augmentait et que les sources se multipliaient, la gestion de cette complexité devenait difficile et exigeait une connaissance approfondie du système. De plus, les infrastructures étant principalement hébergées sur site, les data warehouses et les serveurs locaux supportaient l’ensemble des tâches d’orchestration.
Par conséquent, même les petites entreprises avaient besoin d’équipes conséquentes de data engineers pour assurer le bon fonctionnement de leurs traitements. Cette situation a conduit à une nouvelle approche : simplifier l’extraction et le chargement des données, et décrire les résultats attendus plutôt que chaque étape du traitement.
Des solutions comme Meltano, Airbyte et Fivetran sont apparues pour simplifier ces processus. Le passage de l’ETL — extraction, transformation, chargement — à l’ELT — extraction, chargement, transformation — s’est progressivement imposé. Il s’avérait en effet plus simple d’effectuer les transformations directement dans le data warehouse que de s’appuyer sur une multitude de scripts spécifiques.
Des solutions comme Snowflake ont également simplifié la gestion de l’infrastructure, tandis que les orchestrateurs comme Airflow continuent de coordonner les traitements.
L’évolution des transformations : de l’ETL à l’ELT ✈️
L’un des changements majeurs qui accompagnent la Modern Data Stack est le passage de l’ETL à l’ELT. Cette transition fait évoluer les pratiques, auparavant centrées sur les scripts Python et des outils comme Airflow, vers une approche davantage axée sur SQL.
En utilisant des connecteurs prêts à l’emploi et en réalisant les transformations directement dans le data warehouse, les organisations peuvent simplifier leurs processus et réduire leur dépendance à des scripts complexes développés sur mesure.
Cependant, si l’ELT simplifie certains aspects de la transformation des données, il ne répond pas à tous les besoins. Les transformations sont exécutées dans le data warehouse, et il reste nécessaire de coordonner les traitements et leurs dépendances : c’est le rôle de l’orchestration.
Un nouveau métier apparaît : l’Analytics Engineer 🤓
L’émergence de l’Analytics Engineer est au cœur de la Modern Data Stack.
Ce rôle fait le lien entre l’ingénierie des données traditionnelle et l’analyse, en se concentrant sur les phases de transformation des pipelines ELT. Les analystes peuvent ainsi se consacrer aux transformations, tandis que les data engineers se concentrent sur l’optimisation de l’infrastructure et la préparation des déploiements.
La programmation déclarative 📄
La Modern Data Stack met également l’accent sur la programmation déclarative, qui permet aux utilisateurs de définir le résultat souhaité sans avoir à décrire précisément toutes les étapes nécessaires pour l’obtenir.
Cette approche simplifie les transformations et rend les données plus accessibles aux utilisateurs non techniques. Malgré cette avancée, les projets ELT ne sont pas encore entièrement déclaratifs. La programmation déclarative concerne principalement les étapes d’extraction et de chargement, grâce à des outils comme Meltano, Airbyte ou Fivetran. Ce sont souvent les opérations les plus répétitives, donc les plus faciles à abstraire et à décrire de manière déclarative.
Il n’existe pas encore de véritable solution permettant de définir de manière déclarative les transformations ELT : il faut toujours recourir à des scripts spécifiques et à de l’orchestration. Ce problème n’est donc pas entièrement résolu par la Modern Data Stack.
Les data warehouses cloud en libre-service 👤
La Modern Data Stack s’appuie sur des data warehouses cloud comme Snowflake, Google BigQuery ou Amazon Redshift pour proposer un stockage économique qui s’adapte au volume de données. Ces plateformes offrent souplesse, capacité de montée en charge et simplicité d’utilisation, permettant aux organisations de gérer et d’analyser efficacement de grands volumes de données.
Dans Snowflake, la séparation du stockage et du calcul constitue une caractéristique essentielle pour améliorer les performances et la capacité de montée en charge. Le fonctionnement en libre-service permet aux utilisateurs d’accéder aux données et de les manipuler sans intervention importante des équipes d’ingénierie ni gestion de l’infrastructure.
La couche sémantique et les outils de BI modernes 📊
La couche sémantique est une représentation intermédiaire des données, compréhensible par les utilisateurs finaux. Elle se situe entre les données brutes du data warehouse et les outils d’analyse. Cette couche d’abstraction gagne en popularité, car elle simplifie l’accès aux données et leur interprétation.
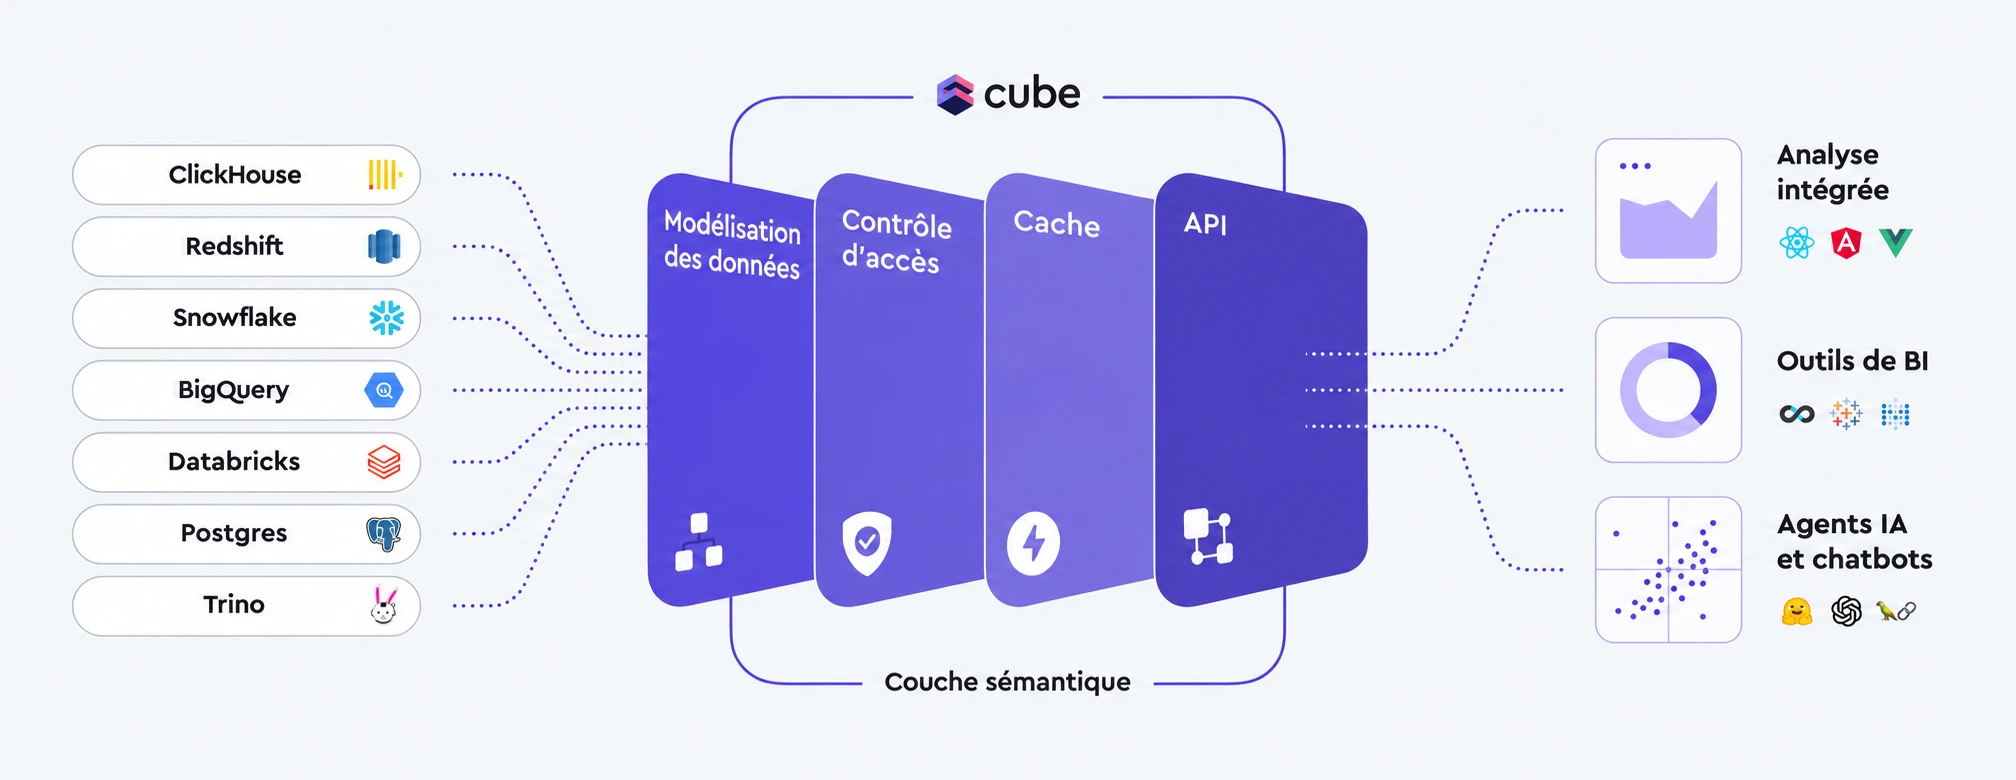
Illustration : le rôle de la couche sémantique — adaptation d’un visuel fourni par Cube.
La Modern Data Stack intègre également des outils de BI modernes, comme Google Looker, Sigma et Rill. Leurs interfaces conviviales permettent d’explorer, de visualiser et d’analyser les données, afin d’en tirer des enseignements sans posséder de compétences approfondies en programmation.
À quoi pourrait ressembler un écosystème de données moderne ?
Examinons les différents composants et services qui peuvent constituer un écosystème de données moderne.
Stockage
- Data warehouses cloud et data lakes : des plateformes comme Snowflake, Databricks, Redshift et BigQuery proposent des solutions de stockage capables de monter en charge.
- Data lakehouses : des technologies comme Apache Iceberg et Delta Lake, reposant par exemple sur AWS S3, fournissent des couches d’abstraction pour gérer efficacement les data lakes.
- Solutions open source : PostgreSQL et DuckDB constituent des alternatives viables, DuckDB proposant notamment des capacités d’analyse de données (OLAP).
Extraction et chargement
- Services managés : Fivetran et Rivery simplifient l’extraction et le chargement des données.
- Solutions open source : Airbyte et Meltano permettent d’adapter l’extraction et le chargement des données à ses besoins.
Transformation et orchestration
- Outils de transformation : dbt permet de structurer les transformations de données dans les pipelines ELT.
- Frameworks d’orchestration : Dagster et Prefect permettent de coordonner les étapes des pipelines de données.
- Scripts et traitements sur mesure : Python, Spark ou des bibliothèques comme Polars permettent de créer des traitements adaptés à des besoins spécifiques.
Outils de Business Intelligence
- Plateformes de visualisation : Looker, Rill et Sigma, ainsi que des outils traditionnels comme Tableau et Power BI, permettent d’analyser les données pour éclairer les décisions métier.
- Alternatives open source : des plateformes comme Evidence et Streamlit proposent des solutions économiques et personnalisables pour créer des visualisations de données interactives.
La force de l’écosystème Modern Data Stack réside dans sa polyvalence et son accessibilité. Même pour les petites entreprises, construire des solutions de données robustes est désormais plus simple, plus rapide et plus économique que jamais. Grâce aux outils gratuits et aux solutions open source, il est tout à fait possible de construire seul des pipelines de données, même sur une seule machine.
Chez Fonction Labs, nous vous accompagnons dans le choix et la mise en place d’une architecture de données adaptée à vos usages, à votre équipe et à votre budget. Parlons de votre projet.